
 English
 Deutsch
 Français
 Italiano
 Nederlands
 Polski
' d='M48 28h24v18a12 12 0 0 1-24 0z'/%3E%3Cpath fill='%230093DD' d='M47.5 21.5h4.6V28h-4.6zm10.2-2.5h4.6v9h-4.6zm10.2 2.5h4.6V28h-4.6z'/%3E%3Cpath fill='%23171796' d='M52.6 20h4.6v8h-4.6zm10.2 0h4.6v8h-4.6z'/%3E%3C/svg%3E) Hrvatski
 עברית
Cómo funcionan las videollamadas en grupo: señalización, malla y servidores multimedia SFU
Una videollamada entre dos personas puede ir directamente de un dispositivo al otro. WebRTC envía la cámara y el micrófono de cada persona directamente a la otra, con un relé solo cuando hay un cortafuegos en medio, como explica nuestro artículo sobre servidores STUN y TURN.
Si se suma una tercera persona, el mismo enfoque sigue funcionando. Con una sexta empieza a desmoronarse: la imagen se congela, el ventilador del portátil se dispara y quien está en el teléfono se cae de la llamada. Las llamadas en grupo necesitan otra arquitectura, y casi todas las apps que las ofrecen acaban llegando a la misma.
Este artículo recorre las piezas: el servidor de señalización que necesita toda llamada, la malla que funciona para unas pocas personas, los dos tipos de servidores multimedia y lo que cambia en el cifrado cuando hay un servidor en medio.
Toda llamada necesita señalización
Antes de que se mueva el audio o el vídeo, los dispositivos de una llamada tienen que ponerse de acuerdo en cómo hacerlo. Cada uno describe lo que puede enviar y recibir, los códecs, las resoluciones y las direcciones en las que se le puede encontrar, y el otro lado responde. En WebRTC se llaman oferta, respuesta y candidatos ICE.
WebRTC no dice cómo viajan. Eso queda en manos de tu app, y la pieza que los lleva es el servidor de señalización. En la práctica es un servidor WebSocket con el que cada página y cada app mantienen una conexión abierta, porque una llamada necesita algo más que el primer intercambio:
- Hacer sonar la llamada. La persona a la que se llama tiene que enterarse de la llamada en cada pestaña y en cada dispositivo que tenga abierto, y dejar de recibir el aviso en cuanto conteste en uno.
- Quién está en la llamada. Todos necesitan saber cuándo alguien entra o sale, enciende la cámara o comparte la pantalla.
- Quién puede entrar. El servidor de señalización es donde una llamada se deja pasar o se rechaza, así que es ahí donde tu app decide quién puede llamar a quién y quién entra en cada llamada en grupo.
El servidor de señalización lleva pocos datos, pero tiene que estar en marcha siempre que pueda empezar una llamada, y tiene que conocer a tus usuarios.
Malla: todos envían a todos
La llamada en grupo más sencilla es una malla (mesh). Cada dispositivo abre una conexión directa con cada uno de los demás y envía su cámara a cada uno de ellos.
Con tres personas, cada dispositivo envía dos copias de su imagen y recibe dos. Eso va bien. El problema es cómo crece:
| Personas en la llamada | Copias que envía cada dispositivo | Conexiones en la llamada |
|---|---|---|
| 3 | 2 | 3 |
| 5 | 4 | 10 |
| 8 | 7 | 28 |
| 12 | 11 | 66 |
Una imagen de cámara de buena calidad se suele enviar a entre uno y dos megabits por segundo. En una llamada de ocho, cada dispositivo tendría que enviar siete a la vez, más de lo que muchas conexiones domésticas y móviles pueden subir de forma estable. Además, el dispositivo suele codificar la imagen por separado para cada conexión, y eso es lo que dispara el ventilador y agota la batería del teléfono.
La malla encaja bien con tres o cuatro personas con buenas conexiones, sin ningún servidor que transporte audio o vídeo. A partir de ahí, la llamada necesita un servidor en medio.
La MCU: una sola imagen mezclada para todos
La respuesta más antigua es la unidad de control multipunto, o MCU. Cada dispositivo envía su imagen al servidor una vez. El servidor las decodifica todas, las dibuja en una sola imagen combinada, la vuelve a codificar y envía esa única imagen a cada persona.
Así, cada dispositivo envía un flujo y recibe uno, lo que resulta ligero para los teléfonos y las redes lentas. El coste pasa al servidor: decodificar y codificar cada imagen de cada llamada exige mucho procesamiento, la mezcla añade retardo y todos ven la misma distribución, la que elige el servidor. Las MCU siguen usándose donde hace falta una sola imagen, por ejemplo cuando una línea telefónica se une a una reunión por vídeo, pero hoy la mayoría de las llamadas en grupo usan el otro tipo de servidor.
La SFU: enviar una vez, reenviar a todos
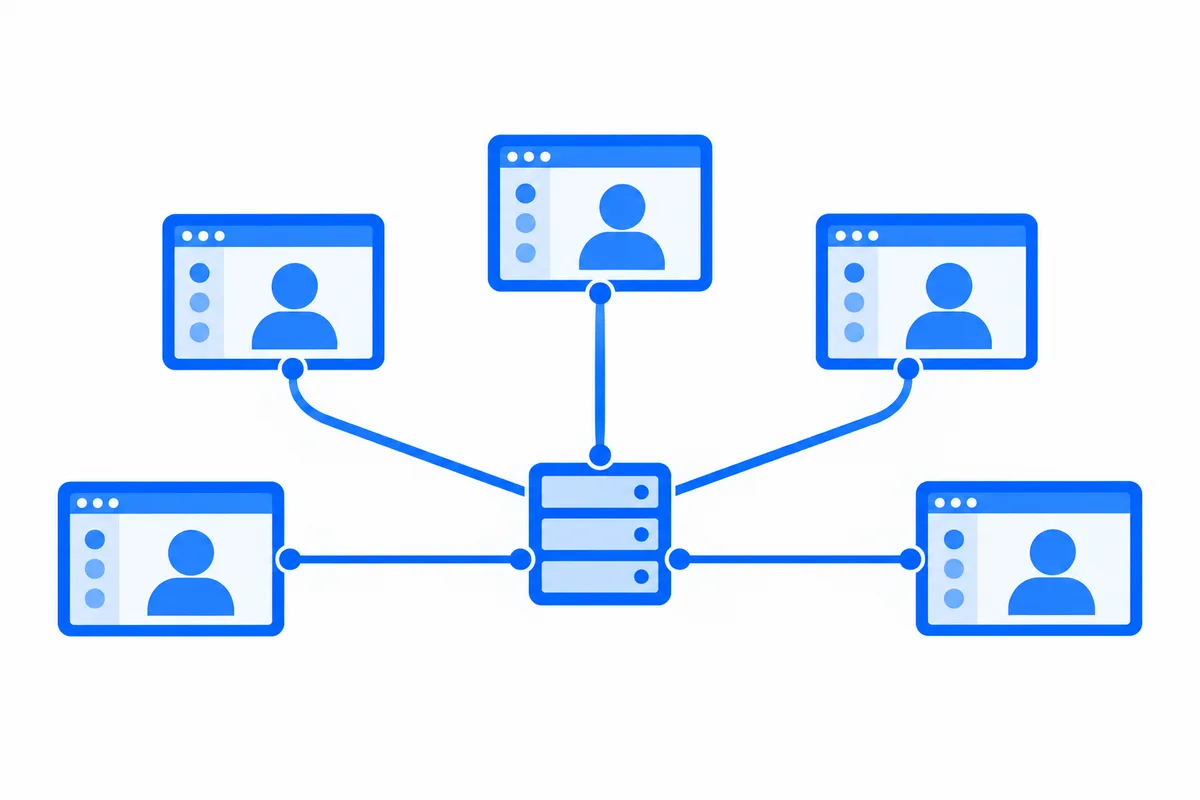
Una unidad de reenvío selectivo, o SFU, es el servidor multimedia sobre el que funcionan la mayoría de las llamadas en grupo. Cada dispositivo envía su imagen a la SFU una vez, y la SFU la reenvía a todos los demás de la llamada, sin decodificarla.
Cada dispositivo envía un solo flujo, sea cual sea el número de personas en la llamada. Recibe un flujo por cada persona que muestra, y ahí es donde entra lo de “selectivo”. Como la SFU está entre cada emisor y cada receptor, puede elegir qué recibe cada persona:
- Varias calidades de cada emisor. Con simulcast, un dispositivo envía su imagen en dos o tres tamaños a la vez, y la SFU reenvía la pequeña a quien la muestra como miniatura o tiene una conexión débil, y la grande a quien la muestra a pantalla completa.
- Solo lo que está en pantalla. En una llamada de treinta, una página que muestra nueve recuadros no necesita las otras veintiuna imágenes. La SFU deja de reenviarlas hasta que se muestren.
- Quién está hablando. La SFU ve el nivel de audio de todos y puede decirle a cada página quién habla en ese momento, para que la página lo muestre en grande.
- Ponentes y oyentes. En una clase o una mesa redonda, unas pocas personas envían y el resto solo recibe. La SFU reenvía a quienes hablan y no recibe nada de los oyentes, así que una llamada puede crecer hasta muchas más personas de las que hay en cámara.
Como la SFU nunca decodifica el audio ni el vídeo, un solo servidor puede reenviar muchísimos flujos. Una llamada muy grande puede repartirse entre varias SFU, cada una atendiendo a las personas que tiene cerca y pasándose los flujos entre ellas, de modo que personas en distintos continentes se conectan cada una a un servidor cercano.
Cuando una persona presenta para todos y el público solo mira, la forma vuelve a cambiar: eso es una transmisión en directo, pensada para un público de cualquier tamaño con un chat al lado, de la que hablamos en transmisión en directo para tu app.
El cifrado con un servidor en medio
Toda conexión WebRTC va cifrada, así que nadie en la red entre un dispositivo y el servidor puede ver ni oír la llamada. En una llamada directa entre dos personas, eso es de extremo a extremo: solo los dos dispositivos tienen las claves.
Con una SFU, la conexión de cada dispositivo termina en el servidor. La SFU descifra lo que llega y lo vuelve a cifrar para cada receptor, así que el servidor podría ver y oír todo lo que reenvía. Para muchas apps eso es aceptable. Para un médico y un paciente, un abogado y su cliente o un equipo que habla de algo privado, no lo es.
La solución es cifrar cada trama de audio y vídeo una segunda vez, dentro del dispositivo, antes de que salga, con una clave que el servidor nunca tiene. Los navegadores actuales lo permiten mediante las encoded transforms de WebRTC. La SFU sigue viendo qué flujo es cuál y los reenvía como antes, pero lo que reenvía va sellado. Las claves salen de tu propio servidor, que solo se las da a las personas que tienen permiso para estar en la llamada.
La contrapartida es que un servidor que no puede leer el audio y el vídeo tampoco puede mezclarlos, grabarlos ni cambiar su formato. Y de eso se trata precisamente.
Mantener tus propios servidores
Existen SFU de código abierto, y son sólidas. Un equipo que mantiene las suyas asume:
- Servidores con direcciones públicas y puertos UDP abiertos, en las regiones donde están tus usuarios, con ancho de banda para cada flujo que reenvían.
- También relés TURN, porque algunas personas siguen sin poder llegar directamente a la SFU, igual que en una llamada entre dos personas.
- Un servidor de señalización que conozca a tus usuarios, haga sonar sus dispositivos y decida quién entra.
- Asignar cada llamada, para que sus participantes acaben en un servidor cercano que tenga sitio, y repartir una llamada grande entre varios servidores.
- Mantenerlo todo en marcha: actualizaciones, monitorización y llamadas que pasan a otro servidor cuando uno falla.
Nada de esto es exótico, pero es un servicio que hay que mantener en marcha mientras tu app tenga llamadas.
Cómo gestiona WordPlus Cloud las llamadas en grupo
WordPlus Cloud lo gestiona todo por ti, de la señalización a los servidores multimedia:
- Señalización sobre la conexión que ya tienen tus páginas. La misma conexión en tiempo real que lleva tus salas y quién está en línea hace sonar una llamada en cada pestaña y cada app de la persona a la que se llama, y avisa a todos en una llamada en grupo de quién entra, sale y habla.
- Llamadas en grupo en nuestros servidores multimedia, en varias regiones. Cada dispositivo envía su cámara una vez, sea cual sea el número de personas en la llamada, y no hay límite de personas por llamada.
- Tu servidor decide. Una regla en tu servidor dice quién puede entrar en cada llamada en grupo, quién habla y quién solo escucha, y quién es anfitrión. Los anfitriones silencian un micrófono, dan la palabra a alguien y sacan a alguien de la llamada, y tu servidor puede hacer lo mismo sin ninguna página abierta.
- Cifrado de extremo a extremo cuando tu regla lo indique. Cada trama se cifra en el navegador con una clave que deriva tu servidor, así que nuestros servidores multimedia reenvían lo que no pueden leer. Una llamada entre dos personas a la que se une alguien más pasa a ser una llamada en grupo y sigue cifrada de extremo a extremo.
- Una pantalla de llamada lista para usar, o la tuya. Usa la ventana de llamada ya hecha en la web, iOS y Android, o crea tu propia interfaz sobre el mismo SDK.
Funciona desde Next.js, Laravel, Django y otros stacks con nuestros SDK, y Better Messages lleva sus llamadas en grupo en WordPress sobre los mismos servidores multimedia. Videollamadas y llamadas en grupo para tu app muestra lo que te dan los SDK, y cómo funcionan las llamadas en nuestra documentación muestra el código.