
 English
 Deutsch
 Español
 Français
 Italiano
 Nederlands
' d='M48 28h24v18a12 12 0 0 1-24 0z'/%3E%3Cpath fill='%230093DD' d='M47.5 21.5h4.6V28h-4.6zm10.2-2.5h4.6v9h-4.6zm10.2 2.5h4.6V28h-4.6z'/%3E%3Cpath fill='%23171796' d='M52.6 20h4.6v8h-4.6zm10.2 0h4.6v8h-4.6z'/%3E%3C/svg%3E) Hrvatski
 עברית
Jak działają grupowe rozmowy wideo: sygnalizacja, mesh i serwery mediów SFU
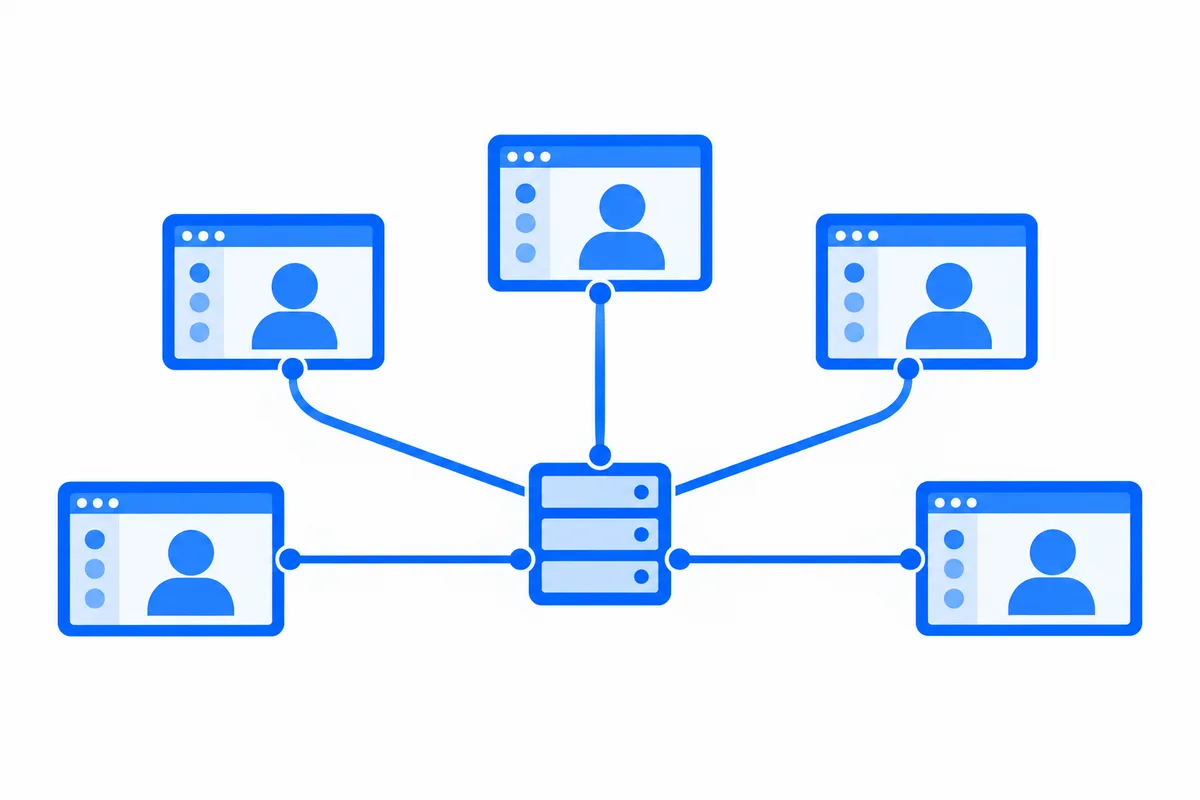
Rozmowa wideo między dwiema osobami może iść prosto z jednego urządzenia na drugie. WebRTC wysyła obraz z kamery i dźwięk z mikrofonu każdej osoby bezpośrednio do drugiej, a przez przekaźnik tylko wtedy, gdy na drodze stoi zapora, jak wyjaśnia nasz wpis o serwerach STUN i TURN.
Dodaj trzecią osobę, a to samo podejście nadal działa. Dodaj szóstą, a wszystko zaczyna się sypać: obraz się zawiesza, wentylator laptopa wchodzi na wysokie obroty, a osoba na telefonie wypada z rozmowy. Rozmowy grupowe wymagają innej architektury i prawie każda aplikacja, która je prowadzi, dochodzi w końcu do tej samej.
Ten wpis omawia po kolei wszystkie elementy: serwer sygnalizacyjny, którego potrzebuje każda rozmowa, mesh, który sprawdza się przy kilku osobach, dwa rodzaje serwerów mediów i to, co zmienia się w szyfrowaniu, gdy pośrodku stoi serwer.
Każda rozmowa potrzebuje sygnalizacji
Zanim popłynie jakikolwiek dźwięk czy obraz, urządzenia w rozmowie muszą uzgodnić, jak to zrobią. Każde z nich opisuje, co może wysyłać i odbierać: kodeki, rozdzielczości i adresy, pod którymi można do niego dotrzeć, a druga strona odpowiada. W WebRTC są to oferta (offer), odpowiedź (answer) i kandydaci ICE.
WebRTC nie określa, jak mają być przesyłane. To zadanie Twojej aplikacji, a tym, co je przenosi, jest serwer sygnalizacyjny. W praktyce to serwer WebSocket, z którym każda strona i aplikacja utrzymuje połączenie, bo rozmowa potrzebuje czegoś więcej niż pierwszej wymiany:
- Dzwonienie. Osoba, do której ktoś dzwoni, musi usłyszeć dzwonek w każdej karcie i na każdym urządzeniu, które ma otwarte, a gdy odbierze na jednym z nich, dzwonek musi ucichnąć.
- Kto jest w rozmowie. Wszyscy muszą się dowiedzieć, gdy ktoś dołącza lub wychodzi, włącza kamerę albo udostępnia ekran.
- Kto może dołączyć. To serwer sygnalizacyjny wpuszcza rozmowę albo ją odrzuca, więc to w nim Twoja aplikacja decyduje, kto może dzwonić do kogo i kto dołącza do każdej rozmowy grupowej.
Serwer sygnalizacyjny przesyła niewiele danych, ale musi działać zawsze, gdy może zacząć się rozmowa, i musi znać Twoich użytkowników.
Mesh: każdy wysyła do każdego
Najprostsza rozmowa grupowa to mesh. Każde urządzenie otwiera bezpośrednie połączenie z każdym innym i wysyła do każdego z nich obraz ze swojej kamery.
Przy trzech osobach każde urządzenie wysyła dwie kopie swojego obrazu i odbiera dwie. To nie problem. Kłopot w tym, jak to rośnie:
| Osoby w rozmowie | Kopie wysyłane przez każde urządzenie | Połączenia w rozmowie |
|---|---|---|
| 3 | 2 | 3 |
| 5 | 4 | 10 |
| 8 | 7 | 28 |
| 12 | 11 | 66 |
Obraz z kamery w dobrej jakości często wysyła się z prędkością od jednego do dwóch megabitów na sekundę. W rozmowie ośmiu osób każde urządzenie wysyłałoby siedem takich strumieni naraz, czyli więcej, niż wiele domowych i mobilnych łączy jest w stanie stabilnie wysyłać. Do tego urządzenie zwykle koduje obraz osobno dla każdego połączenia, przez co wentylator wchodzi na wysokie obroty, a telefon się rozładowuje.
Mesh dobrze sprawdza się przy trzech czy czterech osobach na przyzwoitych łączach, bez żadnego serwera przenoszącego media. Powyżej tego rozmowa potrzebuje serwera pośrodku.
MCU: jeden zmiksowany obraz dla wszystkich
Starszym rozwiązaniem jest MCU (multipoint control unit). Każde urządzenie wysyła swój obraz do serwera raz. Serwer dekoduje je wszystkie, składa w jeden wspólny obraz, ponownie go koduje i wysyła ten jeden obraz każdej osobie.
Każde urządzenie wysyła wtedy jeden strumień i odbiera jeden, co odciąża telefony i wolne sieci. Koszt przenosi się na serwer: dekodowanie i kodowanie każdego obrazu każdej rozmowy wymaga dużej mocy obliczeniowej, miksowanie dodaje opóźnienie, a wszyscy widzą ten sam układ, wybrany przez serwer. MCU wciąż spotyka się tam, gdzie potrzebny jest jeden obraz, na przykład gdy do spotkania wideo dołącza linia telefoniczna, ale większość rozmów grupowych korzysta dziś z drugiego rodzaju serwera.
SFU: wyślij raz, przekaż wszystkim
SFU (selective forwarding unit) to serwer mediów, na którym działa większość rozmów grupowych. Każde urządzenie wysyła swój obraz do SFU raz, a SFU przekazuje go wszystkim pozostałym uczestnikom rozmowy, bez dekodowania.
Każde urządzenie wysyła jeden strumień, niezależnie od liczby osób w rozmowie. Odbiera po jednym strumieniu na każdą osobę, którą pokazuje, i tu właśnie wchodzi w grę „selective” z nazwy. Ponieważ SFU stoi między każdym nadawcą a każdym odbiorcą, może wybierać, co dostaje każda osoba:
- Kilka jakości od każdego nadawcy. Dzięki simulcast urządzenie wysyła swój obraz naraz w dwóch lub trzech rozmiarach, a SFU przekazuje mały temu, kto pokazuje go jako miniaturę albo ma słabe łącze, i duży temu, kto wyświetla go na pełnym ekranie.
- Tylko to, co widać na ekranie. W rozmowie trzydziestu osób strona, która pokazuje dziewięć kafelków, nie potrzebuje pozostałych dwudziestu jeden obrazów. SFU przestaje je przekazywać, dopóki nie pojawią się na ekranie.
- Kto mówi. SFU widzi poziom dźwięku u wszystkich i może podać każdej stronie, kto teraz mówi, a strona może tę osobę powiększyć.
- Mówcy i słuchacze. Na zajęciach albo w panelu dyskusyjnym kilka osób nadaje, a wszyscy pozostali tylko odbierają. SFU przekazuje mówców i nie bierze nic od słuchaczy, więc rozmowa może urosnąć do znacznie większej liczby osób, niż jest przed kamerą.
Ponieważ SFU nigdy nie dekoduje mediów, jeden serwer może przekazywać bardzo wiele strumieni. Bardzo duża rozmowa może rozciągać się na kilka SFU, z których każdy obsługuje osoby w pobliżu i wymienia strumienie z pozostałymi, więc ludzie na różnych kontynentach łączą się każdy z serwerem blisko siebie.
Gdy jedna osoba występuje przed wszystkimi, a widzowie tylko oglądają, architektura znów się zmienia: to transmisja na żywo, stworzona dla widowni dowolnej wielkości, z czatem obok, o której piszemy na stronie Transmisje na żywo dla Twojej aplikacji.
Szyfrowanie, gdy pośrodku stoi serwer
Każde połączenie WebRTC jest szyfrowane, więc nikt w sieci między urządzeniem a serwerem nie może zobaczyć ani usłyszeć rozmowy. W bezpośredniej rozmowie między dwiema osobami jest to szyfrowanie end-to-end: klucze mają tylko oba urządzenia.
Z SFU połączenie każdego urządzenia kończy się na serwerze. SFU odszyfrowuje to, co do niego dociera, i szyfruje ponownie dla każdego odbiorcy, więc serwer mógłby zobaczyć i usłyszeć wszystko, co przekazuje. Dla wielu aplikacji to do przyjęcia. Dla lekarza i pacjenta, prawnika i klienta albo zespołu omawiającego coś poufnego już nie.
Rozwiązaniem jest zaszyfrowanie każdej ramki dźwięku i obrazu po raz drugi, jeszcze na urządzeniu, zanim je opuści, kluczem, którego serwer nigdy nie ma. Obecne przeglądarki obsługują to przez WebRTC encoded transforms. SFU nadal widzi, który strumień jest który, i przekazuje je jak wcześniej, ale to, co przekazuje, pozostaje dla niego zamknięte. Klucze pochodzą z Twojego własnego serwera, który daje je tylko osobom dopuszczonym do rozmowy.
Ceną jest to, że serwer, który nie może odczytać mediów, nie może ich też miksować, nagrywać ani zmieniać ich formatu. I właśnie o to chodzi.
Uruchamianie własnych serwerów
Istnieją solidne SFU open source. Zespół, który uruchamia własny, bierze na siebie:
- Serwery z publicznymi adresami i otwartymi portami UDP, w regionach, w których są Twoi użytkownicy, z przepustowością na każdy strumień, który przekazują.
- Do tego przekaźniki TURN, bo niektóre osoby nadal nie mogą połączyć się z SFU bezpośrednio, tak samo jak w rozmowie między dwiema osobami.
- Serwer sygnalizacyjny, który zna Twoich użytkowników, dzwoni na ich urządzenia i decyduje, kto dołącza.
- Rozmieszczanie każdej rozmowy, tak aby jej uczestnicy trafiali na pobliski serwer, który ma wolne zasoby, oraz rozkładanie dużej rozmowy na kilka serwerów.
- Utrzymanie wszystkiego w ruchu: aktualizacje, monitorowanie i rozmowy, które przenoszą się na inny serwer, gdy któryś zawiedzie.
Nic z tego nie jest egzotyczne, ale to usługa, którą trzeba utrzymywać tak długo, jak Twoja aplikacja ma rozmowy.
Jak WordPlus Cloud obsługuje rozmowy grupowe
WordPlus Cloud robi to wszystko za Ciebie, od sygnalizacji po serwery mediów:
- Sygnalizacja przez połączenie, które Twoje strony już mają. To samo połączenie w czasie rzeczywistym, które obsługuje Twoje pokoje i pokazuje, kto jest online, uruchamia dzwonek w każdej karcie i aplikacji osoby, do której ktoś dzwoni, i informuje wszystkich w rozmowie grupowej, kto dołącza, wychodzi i mówi.
- Rozmowy grupowe na naszych serwerach mediów, w kilku regionach. Każde urządzenie wysyła obraz z kamery raz, niezależnie od liczby osób w rozmowie, i nie ma limitu osób w rozmowie.
- Decyduje Twój serwer. Reguła na Twoim serwerze określa, kto może dołączyć do każdej rozmowy grupowej, kto mówi, kto tylko słucha i kto prowadzi rozmowę. Prowadzący mogą wyciszyć czyjś mikrofon, dać komuś głos i usunąć kogoś z rozmowy, a Twój serwer może zrobić to samo bez żadnej otwartej strony.
- Szyfrowanie end-to-end, gdy tak określa Twoja reguła. Każda ramka jest szyfrowana w przeglądarce kluczem wyprowadzonym przez Twój serwer, więc nasze serwery mediów przekazują coś, czego nie mogą odczytać. Rozmowa między dwiema osobami, do której dołącza ktoś jeszcze, staje się rozmową grupową i pozostaje szyfrowana end-to-end.
- Gotowy ekran rozmowy albo Twój własny. Użyj gotowego okna rozmowy w przeglądarce, na iOS i Androidzie albo zbuduj własny interfejs na tym samym SDK.
Działa to w Next.js, Laravel, Django i innych stackach, z naszymi SDK, a Better Messages na WordPress obsługuje swoje rozmowy grupowe na tych samych serwerach mediów. Strona Rozmowy wideo i rozmowy grupowe dla Twojej aplikacji pokazuje, co dają SDK, a jak działają rozmowy w naszej dokumentacji pokazuje kod.