
 English
 Deutsch
 Español
 Français
 Nederlands
 Polski
' d='M48 28h24v18a12 12 0 0 1-24 0z'/%3E%3Cpath fill='%230093DD' d='M47.5 21.5h4.6V28h-4.6zm10.2-2.5h4.6v9h-4.6zm10.2 2.5h4.6V28h-4.6z'/%3E%3Cpath fill='%23171796' d='M52.6 20h4.6v8h-4.6zm10.2 0h4.6v8h-4.6z'/%3E%3C/svg%3E) Hrvatski
 עברית
Come funzionano le videochiamate di gruppo: signaling, mesh e media server SFU
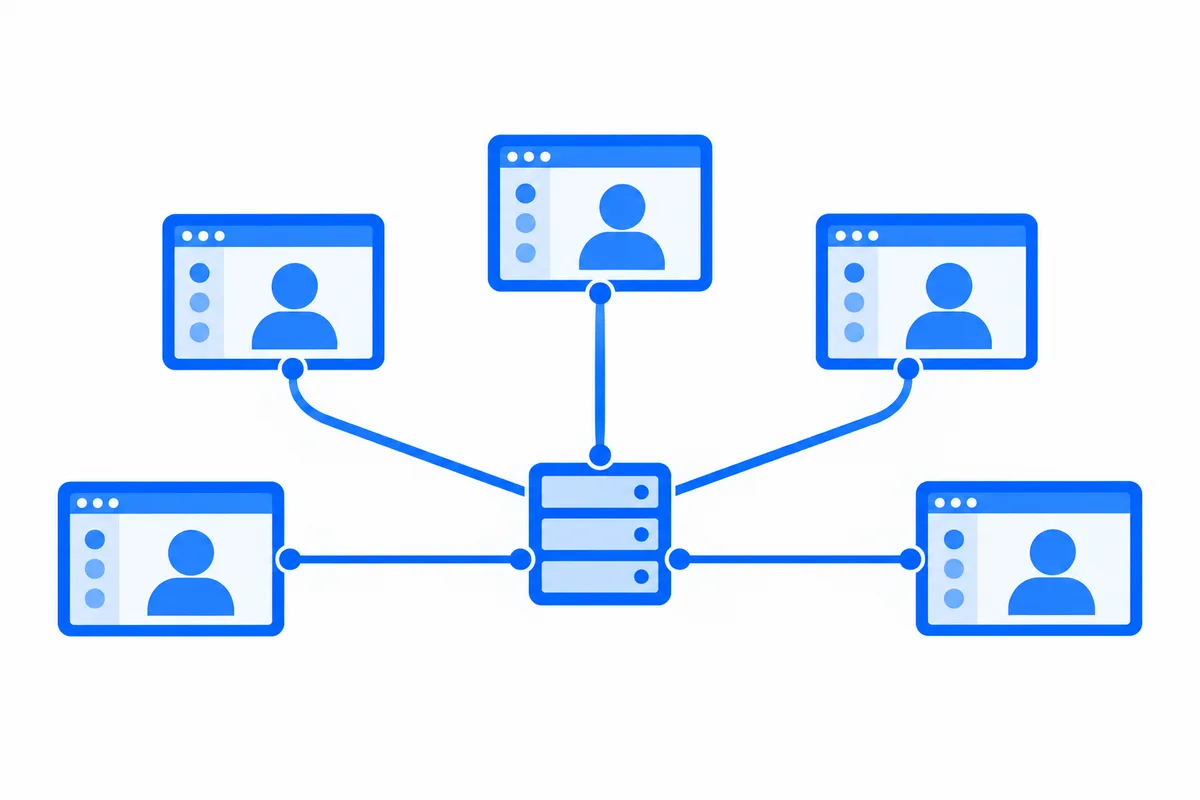
Una videochiamata tra due persone può andare direttamente da un dispositivo all’altro. WebRTC invia la fotocamera e il microfono di ciascuno direttamente all’altro, con un relay solo quando c’è di mezzo un firewall, come spiega il nostro articolo sui server STUN e TURN.
Aggiungi una terza persona e lo stesso approccio funziona ancora. Aggiungine una sesta e comincia a cedere: l’immagine si blocca, la ventola del portatile parte a tutta velocità e chi è collegato dal telefono cade dalla chiamata. Le chiamate di gruppo richiedono una struttura diversa, e quasi ogni app che le offre finisce per arrivare alla stessa.
Questo articolo ne passa in rassegna i pezzi: il server di signaling che serve a ogni chiamata, la mesh che funziona per poche persone, i due tipi di media server e cosa cambia per la cifratura quando c’è un server in mezzo.
Ogni chiamata ha bisogno del signaling
Prima che si muova qualsiasi audio o video, i dispositivi di una chiamata devono mettersi d’accordo su come farlo. Ognuno descrive cosa può inviare e ricevere, i codec, le risoluzioni e gli indirizzi a cui è raggiungibile, e l’altro capo risponde. In WebRTC sono l’offer, l’answer e i candidati ICE.
WebRTC non dice come debbano viaggiare. È una cosa lasciata alla tua app, e la parte che li trasporta è il server di signaling. In pratica è un server WebSocket con cui ogni pagina e ogni app tiene aperta una connessione, perché a una chiamata non basta il primo scambio:
- Lo squillo. La persona chiamata deve venire a sapere della chiamata in ogni scheda e su ogni dispositivo che ha aperto, e smettere di riceverla appena risponde su uno di essi.
- Chi è nella chiamata. Tutti devono sapere quando qualcuno entra o esce, accende la fotocamera o condivide lo schermo.
- Chi può entrare. È sul server di signaling che una chiamata viene accettata o rifiutata, quindi è lì che la tua app decide chi può chiamare chi e chi entra in ogni chiamata di gruppo.
Il server di signaling trasporta pochi dati, ma deve essere attivo ogni volta che una chiamata potrebbe iniziare, e deve conoscere i tuoi utenti.
Mesh: tutti inviano a tutti
La chiamata di gruppo più semplice è una mesh. Ogni dispositivo apre una connessione diretta con ciascuno degli altri e invia a ognuno l’immagine della sua fotocamera.
Con tre persone, ogni dispositivo invia due copie della sua immagine e ne riceve due. Nessun problema. Il guaio è come cresce:
| Persone nella chiamata | Copie inviate da ogni dispositivo | Connessioni nella chiamata |
|---|---|---|
| 3 | 2 | 3 |
| 5 | 4 | 10 |
| 8 | 7 | 28 |
| 12 | 11 | 66 |
L’immagine di una fotocamera in buona qualità viene spesso inviata a uno o due megabit al secondo. In una chiamata a otto, ogni dispositivo ne invierebbe sette contemporaneamente, più di quanto molte connessioni domestiche e mobili riescano a reggere in upload con costanza. Di solito il dispositivo codifica anche l’immagine separatamente per ogni connessione, ed è questo che fa partire la ventola e scarica il telefono.
La mesh va bene per tre o quattro persone con connessioni discrete, senza nessun server a trasportare i media. Oltre, la chiamata ha bisogno di un server in mezzo.
L’MCU: un’unica immagine composta per tutti
La risposta più vecchia è la multipoint control unit, o MCU. Ogni dispositivo invia la sua immagine al server una volta sola. Il server le decodifica tutte, le dispone in un’unica immagine combinata, la codifica di nuovo e invia quella singola immagine a ogni persona.
Ogni dispositivo quindi invia un solo flusso e ne riceve uno, il che pesa poco su telefoni e reti lente. Il costo si sposta sul server: decodificare e codificare ogni immagine di ogni chiamata richiede molta potenza di calcolo, la composizione aggiunge ritardo, e tutti vedono lo stesso layout, scelto dal server. L’MCU si trova ancora dove serve un’unica immagine, come quando una linea telefonica si collega a una riunione video, ma oggi la maggior parte delle chiamate di gruppo usa l’altro tipo di server.
L’SFU: invia una volta, inoltra a tutti
Una selective forwarding unit, o SFU, è il media server su cui gira la maggior parte delle chiamate di gruppo. Ogni dispositivo invia la sua immagine all’SFU una volta sola, e l’SFU la inoltra a tutti gli altri nella chiamata, senza decodificarla.
Ogni dispositivo invia un solo flusso, qualunque sia il numero di persone nella chiamata. Ne riceve uno per ogni persona che mostra, ed è qui che entra in gioco il “selective”. Dato che l’SFU sta tra ogni mittente e ogni destinatario, può scegliere cosa riceve ciascuno:
- Più qualità da ogni mittente. Con il simulcast, un dispositivo invia la sua immagine in due o tre dimensioni contemporaneamente, e l’SFU inoltra quella piccola a chi la mostra come miniatura o ha una connessione debole, e quella grande a chi la mostra a schermo intero.
- Solo ciò che è sullo schermo. In una chiamata a trenta, una pagina che mostra nove riquadri non ha bisogno delle altre ventuno immagini. L’SFU smette di inoltrarle finché non vengono mostrate.
- Chi sta parlando. L’SFU vede i livelli audio di tutti e può dire a ogni pagina chi sta parlando in quel momento, così la pagina può mostrarlo in grande.
- Chi parla e chi ascolta. In una lezione o in un panel, poche persone inviano e tutti gli altri ricevono soltanto. L’SFU inoltra chi parla e non prende nulla da chi ascolta, così una chiamata può arrivare a molte più persone di quante siano in video.
Dato che l’SFU non decodifica mai i media, un solo server può inoltrare moltissimi flussi. Una chiamata molto grande può estendersi su più SFU: ogni server serve le persone vicine a sé e i server si passano i flussi tra loro, così chi si trova in continenti diversi si collega comunque a un server vicino.
Quando una persona presenta a tutti e il pubblico guarda soltanto, la struttura cambia di nuovo: è un live streaming, pensato per un pubblico di qualsiasi dimensione con una chat accanto, di cui parliamo in live streaming per la tua app.
La cifratura con un server in mezzo
Ogni connessione WebRTC è cifrata, quindi nessuno sulla rete tra un dispositivo e il server può vedere o sentire la chiamata. In una chiamata diretta tra due persone, questo vuol dire end-to-end: solo i due dispositivi hanno le chiavi.
Con un server SFU, la connessione di ogni dispositivo termina sul server. L’SFU decifra ciò che arriva e lo cifra di nuovo per ogni destinatario, quindi il server potrebbe vedere e sentire tutto ciò che inoltra. Per molte app è accettabile. Per un medico e un paziente, un avvocato e un cliente, o un team che discute di qualcosa di riservato, non lo è.
La soluzione è cifrare ogni frame di audio e video una seconda volta, dentro il dispositivo, prima che parta, con una chiave che il server non ha mai. I browser attuali lo supportano tramite le WebRTC encoded transforms. L’SFU vede ancora quale flusso è quale e li inoltra come prima, ma ciò che inoltra è sigillato. Le chiavi arrivano dal tuo server, che le dà solo alle persone ammesse nella chiamata.
Il compromesso è che un server che non può leggere i media non può nemmeno comporli, registrarli o cambiarne il formato. Ed è proprio questo lo scopo.
Gestire un tuo media server
Esistono server SFU open source validi e solidi. Un team che ne gestisce uno suo si fa carico di:
- Server con indirizzi pubblici e porte UDP aperte, nelle regioni in cui si trovano i tuoi utenti, con banda per ogni flusso che inoltrano.
- Anche i relay TURN, perché alcune persone non riescono comunque a raggiungere direttamente l’SFU, proprio come in una chiamata tra due persone.
- Un server di signaling che conosce i tuoi utenti, fa squillare i loro dispositivi e decide chi entra.
- La collocazione di ogni chiamata, perché le sue persone finiscano su un server vicino a loro che abbia spazio, e la distribuzione di una chiamata grande su più server.
- Mantenerlo attivo: aggiornamenti, monitoraggio, e chiamate che passano a un altro server quando uno si guasta.
Niente di tutto questo è esotico, ma è un servizio da tenere in funzione finché la tua app ha delle chiamate.
Come WordPlus Cloud gestisce le chiamate di gruppo
WordPlus Cloud gestisce tutto al posto tuo, dal signaling ai media server:
- Il signaling sulla connessione che le tue pagine hanno già. La stessa connessione in tempo reale che trasporta le tue stanze e chi è online fa squillare una chiamata in ogni scheda e app della persona chiamata, e dice a tutti in una chiamata di gruppo chi entra, chi esce e chi parla.
- Chiamate di gruppo sui nostri media server, in diverse regioni. Ogni dispositivo invia la sua fotocamera una volta sola, qualunque sia il numero di persone nella chiamata, e non c’è limite di persone per chiamata.
- Decide il tuo server. Una regola sul tuo server stabilisce chi può entrare in ogni chiamata di gruppo, chi parla e chi ascolta soltanto, e chi fa da host. Gli host spengono un microfono, fanno parlare qualcuno e tolgono qualcuno dalla chiamata, e il tuo server può fare lo stesso senza nessuna pagina aperta.
- Cifratura end-to-end quando la tua regola lo dice. Ogni frame viene cifrato nel browser con una chiave che deriva il tuo server, quindi i nostri media server inoltrano ciò che non possono leggere. Una chiamata tra due persone a cui si unisce qualcun altro diventa una chiamata di gruppo e resta cifrata end-to-end.
- Una schermata di chiamata pronta da usare, o la tua. Usa la finestra di chiamata già pronta sul web, su iOS e su Android, o costruisci la tua interfaccia sullo stesso SDK.
Funziona da Next.js, Laravel, Django e altri stack con i nostri SDK, e su WordPress Better Messages fa girare le sue chiamate di gruppo sugli stessi media server. Videochiamate e chiamate di gruppo per la tua app mostra cosa ti danno gli SDK, e come funzionano le chiamate nella nostra documentazione mostra il codice.